高鐵:固定的多步驟查詢
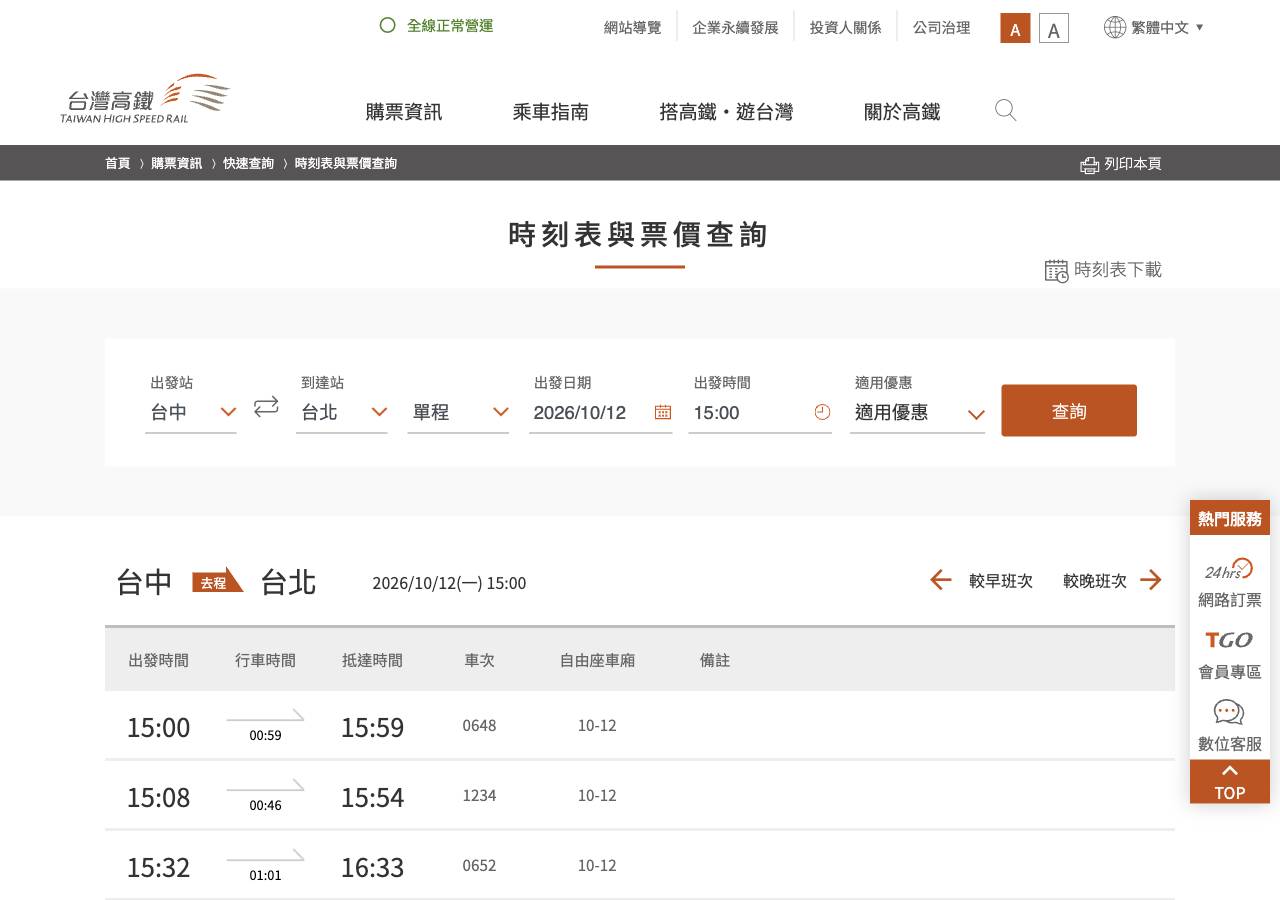
同一句「查 10/12 下午三點以後台中到台北的高鐵」,分別交給 Kav 流程與 Claude in Chrome 逐步操作瀏覽器。2026/09/29 的紀錄如下。
| 任務 | Kav | 逐步操作瀏覽器 |
|---|---|---|
| 高鐵時刻查詢 | 約 22 秒 | 約 116 秒 |
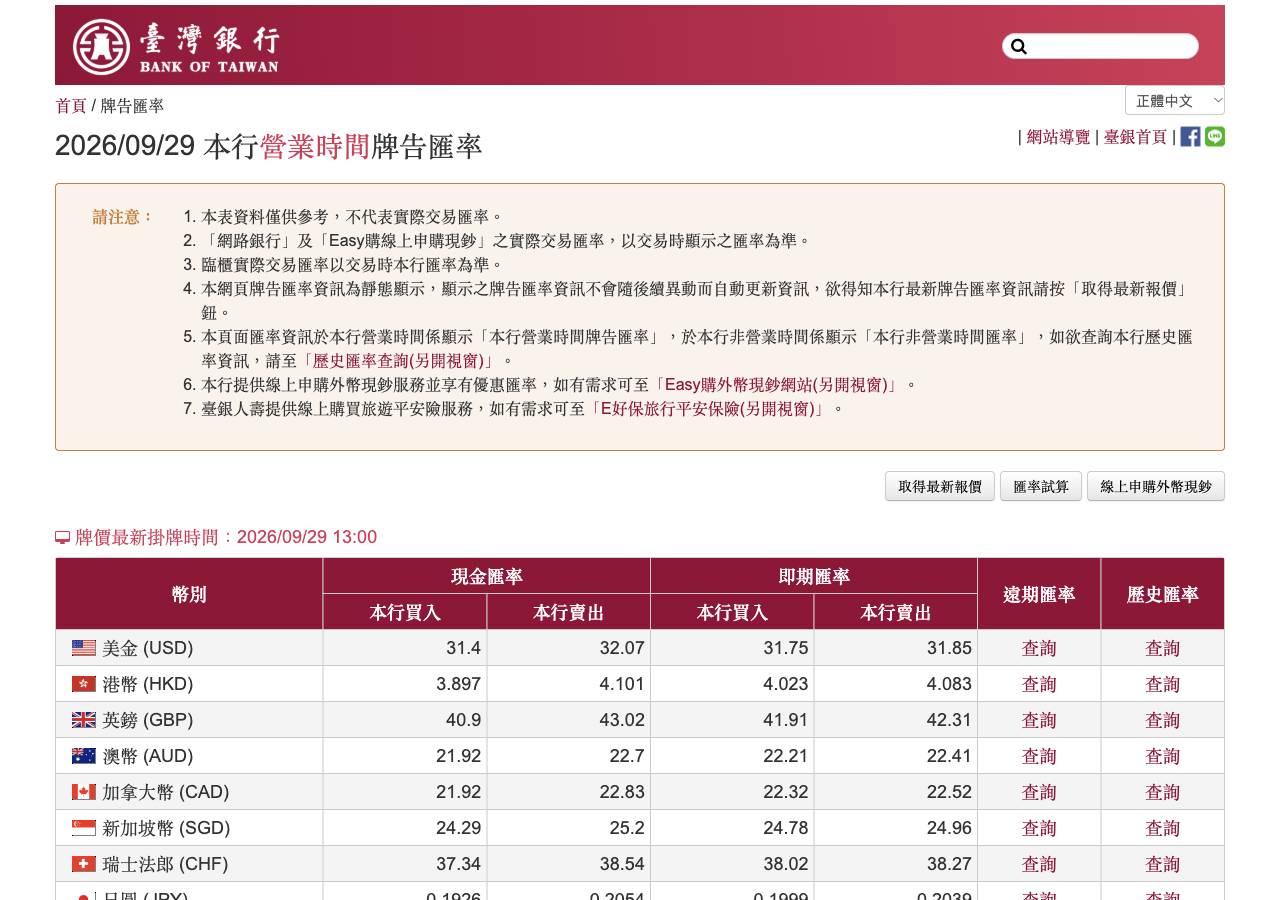
| 台銀匯率讀表 | 19 秒 | 20 秒 |
約 22 秒與 116 秒是整趟對話時間,從使用者提出需求,到最後一則回覆。另一份單次紀錄中,Kav 程式本身執行高鐵流程花了 6.4 秒,Kev 呼叫 0 次。兩種計時不能混為一談。
原始對照,不藏失敗
- Kav:22 秒(修正前誤讀抵達時間)、20 秒、23 秒。
- 逐步操作瀏覽器:118、151、98、98 秒;151 秒那次曾誤點並重填。
- Kav 列出 5 班,對照有時翻頁查到更多班次,因此工作量不完全相等。
- 首次誤讀後,流程增加欄名,重跑答案才與官網一致。
台銀:這一次,沒有比較快
各做一次「讀今天美元與日圓現金賣出匯率」。Kav 19 秒,逐步操作瀏覽器 20 秒。單頁讀表本來就短,這份實驗沒有顯示速度優勢。
這個流程另有一個實用條件:核對掛牌日期。如果不是今天,就不能拿舊資料充數。台銀流程不使用 Kev。
591:省在抓取,判斷仍交給 Claude
2026/10/07,591 租屋列表實驗把「取得資料」與「挑哪一筆」拆開測。本機引擎抓 30 筆文字只花 31 毫秒;Claude 自己操作瀏覽器,三題各花 21–162 秒、45–91 萬輸入 token(含快取累計)。省下重複網頁操作的時間與 token,才是流程的價值。
判斷端,Kev 零錯選,但需要模型的唯一解只答對 4/11;兩條件並列或「最便宜」這類題目會停下。Claude 讀同一份文字全對。因此,抓資料交給本機程式,判斷題把抓好的文字交給 Claude;Kev 保留為單一屬性、離線或零雲端判斷成本的選配。
31 毫秒只量抓取階段,不含整趟載入、判斷與回覆,不能直接換算加速倍率。各組題數與列表版本不同:Claude 讀文字是 26 列版 16 題全對,瀏覽器組另測 3 題全對。
同一實驗,三種量測範圍
| 路徑 | 實測範圍 | 結果與時間 |
|---|---|---|
| 引擎+Kev | 30 列、18 題;13 題唯一解含 2 題字面比對 | 排除字面比對後 4/11;5 題該停全停,零錯選。Kev 約 1.1 秒/題。 |
| Claude 讀抓好的文字 | 26 列版、16 題:11 題唯一解、5 題該停 | 16/16 全對;整批 24.6 秒,約 1.5 秒/題。 |
| Claude in Chrome | 真實頁面、另測 3 題;選擇瀏覽器的回合不計時 | 3/3 全對;43/162/21 秒,輸入含快取累計 91/61/45 萬 token。 |
這些 token 是 session usage 的累計輸入,含快取讀寫,不等於同樣數量的新輸入或可直接推算的費用。資料量與題組不同,這是分階段證據,不是完整同題的端到端對照。
實驗只量「選哪一列」,沒有完成端到端點擊。591 卡片的標題文字每列不同,且會開新分頁,現有 pick 路徑無法完成。擷取規則也曾寫得太窄而漏掉 4/30 列;最新程式回傳 rows_skipped,讓 Claude 看得到漏列訊號,仍需要核對規則是否完整。
來源:README「數字怎麼量的」、DECISIONS 2026-10-07 與實驗紀錄 261007-pick-judgment-experiment;原始題組與結果在專案 evals/pick-591/。
比價:曾使用 Kev 的歷史樣本
Switch 2 在四家網站搜尋的既有紀錄為 5.6–7.8 秒。Kev 呼叫 18–31 次,約 6–11 千 token,在本機執行。價格還會回到商品頁核對一次。
這不是與另一種方法的速度對照。組合包判斷仍有誤判,部分網站也會阻擋自動化,因此不能宣稱查到的就是全網最低價。
錄製:真人示範,重播核對
2026/09/30 在真實高鐵網站進行第 1 階段驗收。前兩次遇到錄製/轉草稿問題;修正後,第 3 次示範成功產出流程草稿。這不是第一次操作就全部成功。
- 示範值在乾淨環境重播:第一次被 cookie 視窗擋住;補上對應步驟後,6.2 秒完成,與使用者標記的 5 班車逐格一致。
- 換一組參數(台中到左營、10/07 09:00):6.8 秒完成,5 列結果與截圖一致。
- 修正後那次使用者示範約 63 秒;這是示範成本,不能與重用流程的執行時間混算。
- 使用者於 2026/10/01 確認儲存,2026/10/07 已存成高鐵示範流程。
- 第 2 階段多步驟、第 3 階段用示範修流程,仍待真人驗收;2026/10/07 已暫停,591 示範發現的篩選遺漏與結果區塊辨識缺口尚未修復。
高鐵本來就能直接寫出流程,示範不一定更省時間。錄製更值得驗證的用途,是難以用語言描述、或 Claude 無法直接寫對的網站。
來源:260930-thsr-demo-acceptance 與 2026/10/07 專案狀態。
這些限制,還需要更多驗證
- 高鐵是單站小樣本;台銀每組只有一次。
- 對照 session 可能讀到釘選記憶,不是完全乾淨的盲測。
- 一次性建立流程、修復與安裝時間不包含在重用查詢比較內。
- 修復只盲測過一個網站、兩種壞法。
- 多步驟錄製、用示範修流程、Windows 與 Codex 使用方式仍有未驗證項目。
來源:專案歷史紀錄 260929-control-experiment-and-demo、260929-kev-usage-accounting,以及 2026/10/07 專案狀態。閱讀可下載的量測摘要。